Groq + Firecrawl:一边把网页洗成干净文本,一边用最便宜的一档模型批量啃
今天这两个工具能接成一条线。Firecrawl 负责把任意网页变成模型能直接读的文本或 JSON,Groq 负责用很低的单价把这些文本批量处理掉。
选它们是因为价格表好算。Firecrawl 按页计费,Groq 按 token 计费,两边的单价都能在官方页面读到明码。我把两边的官方页面都核了一遍,日期标在每段后面。
两个主角本期都未在你的账号里部署,能力和价格全部来自官方页面。
主角一 · Groq:把每百万 token 的推理单价压到一美元以下
段 1 · 是什么
它替你把「模型推理」这一步变成按量付费。你手上有大批文本要抽取、分类或清洗,它按 token 收费,跑得快,单价低。
它最大的价值不是模型多强,是同一套 OpenAI 协议。你现有的脚本把 base_url 改一行就能切过来,不用重写调用层。
段 2 · 多少钱
美国区,计价货币美元,官方文档按每百万 token 标价,核验日期 2026-10-06:
| 模型 | 输入 / 每百万 token | 输出 / 每百万 token ||---|---|---|| openai/gpt-oss-20b | $0.075 | $0.30 || openai/gpt-oss-120b | $0.15 | $0.60 || openai/gpt-oss-safeguard-20b | $0.075 | $0.30 || qwen/qwen3.8-27b | $0.80 | $4.00 || whisper-large-v3 | $0.111 / 小时 | 语音转文字 || whisper-large-v3-turbo | $0.04 / 小时 | 语音转文字 || canopylabs/orpheus-v1-english | $22 / 百万字符 | 文字转语音 |
免费版必提。官方限速页把免费档和开发者档分标签列出,注册即可用,不用绑卡。
坑在这里,逐条说:
- 批量接口打五折,但要等。官方文档写明批量比同步便宜 50%,处理窗口是 24 小时到 7 天。
- 两个折扣不叠加。官方原话:批量折扣不与提示缓存折扣叠加,批量 token 一律按五折计。想吃缓存就别走批量。
- 免费档 token 额度很低。gpt-oss 两款免费档只有 8K token/分钟、200K token/天,一段长文可能一次顶满。
- 两款老模型已转企业档。Llama 3.1 8B 和 Llama 3.3 70B 在官方模型页的价格写的是 Contact Sales,个人按量档拿不到。
- 价格不含税,按美元结算。
段 3 · 适合谁
- 你有一批文档或网页文本要做抽取、打标、去重,量在几万条上下。
- 你需要低延迟的在线调用,比如给对话或 agent 做实时输出。
- 你想把本地脚本从别家切到更便宜的按量价,但不想改调用层。
如果你只跑几次短对话,免费档的每分钟额度就够,付费意义不大。
段 4 · 局限
- 免费档限速卡得很紧。gpt-oss-120b 免费档是 30 请求/分钟、8K token/分钟,长文本批量跑不动。
- 批量窗口最长 7 天。要当天出结果的任务不能走批量,只能吃同步原价。
- 模型选择比别家少。官方模型页在售的开源模型就那几款,没有你要的型号就得换厂商。
- 限速归属有歧义。官方限速页把这套数字放在免费档标签下,页内又有一句「以下为开发者档基础限速」的说明,两边口径对不上。以你自己账号的 Limits 页为准。
- 本文未在你的账号实测,没有跑延迟和吞吐的数字。
段 5 · 今天怎么开始
- 建 key 后把 base_url 指向
https://api.groq.com/openai/v1,协议兼容,先跑通一次最小调用。 - 先用
openai/gpt-oss-20b。它是最便宜的一档,官方标注输出约 1,000 token/秒。 - temperature 压到 0.2,让它按固定 schema 输出 JSON,做结构化抽取更稳。
- 上量前先估成本:1,000 万输入加 500 万输出,按 gpt-oss-20b 同步价算是 $2.25,走批量折半是 $1.125。这是按官方标价算的,未实测。
- 请求前缀大量重复才开缓存,否则缓存省不到钱。缓存和批量只能二选一。
段 6 · 来源
- 定价与限速:https://console.groq.com/docs/models (核验日期 2026-10-06,美元)
- 限速细节:https://console.groq.com/docs/rate-limits
- 批量折扣:https://console.groq.com/docs/batch
- 页面可查:在售模型、每百万 token 单价、上下文长度、语音与语音合成的单价、批量折扣规则
- 页面未提供:中文长文本的实际抽取质量
主角二 · Firecrawl:把网页变成能直接喂给模型的文本或 JSON
段 1 · 是什么
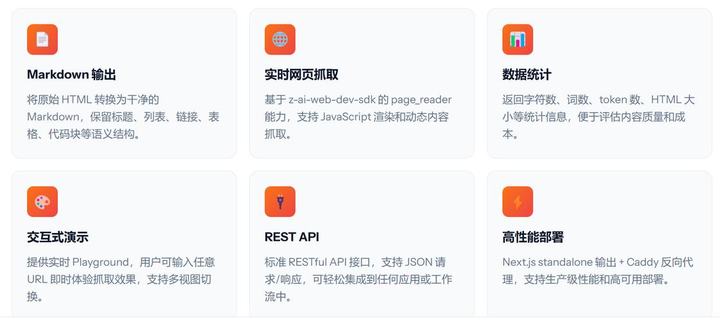
它替你把「抓网页并清洗」这一步干了。你给它一个 URL,它返回干净的 markdown,或者按你给的字段返回结构化 JSON。
省掉的动作很具体:你不用自己处理 JS 渲染、代理轮换和 DOM 解析。对用到模型的流程来说,干净的 markdown 还能省下大量输入 token。
段 2 · 多少钱
美国区,计价货币美元,官方定价页按月付和年付两档写,核验日期 2026-10-06:
| 方案 | 月付 | 年付折算/月 | 每月额度 | 并发 ||---|---|---|---|---|| Free | $0 | $0 | 1,000 credits | 2 || Hobby | $19 | $16 | 5,000 credits | 5 || Standard | $99 | $83 | 100,000 credits | 25 || Growth | $399 | $333 | 500,000 credits | 50 || Scale | $749 | $599 | 1,000,000 credits | 100 |
免费版必提。每月 1,000 credits,按月刷新,不用绑卡。
额度怎么换算,官方定价页写得很细:
- 基础抓取:1 credit 抓 1 个页面,scrape、crawl、map 都是这个价。
- 搜索:每 10 条结果 2 credits。
- 交互:每浏览器分钟 2 credits。
- 结构化输出:scrape 和 crawl 上,JSON、Question、Highlight 三种格式每种每页各加 4 credits。
- 监控:默认 1 credit / 页 / 次检查;官方正文另提到确定性抽取引擎按 7 credits / 页 / 次计。
四条要留意的坑:
- 币种按访问地切换。同一个页面按你所在地区显示美元、欧元、人民币或新加坡元,数字都不同。我这边读到的是美元档。官方写明按美元结算,实际扣款受汇率影响。
- 失败请求也计费。官方写明:返回空结果不计费;但页面返回 403、404 这类错误状态,内容仍会返回给你,并且扣 1 credit。
- 额度不结转。自助档的额度不滚存到下个月,只有 Scale 及以上支持结转一个月。
- 加量按档定价。超出额度后可开按量付费,按 5 美元一档充值并设月度上限,各档的每 credit 单价不同。价格不含税。
段 3 · 适合谁
- 你要把几十上百个页面批量抓成干净文本,再交给模型做摘要或抽取。
- 你要定时盯住某个定价页或更新日志,只关心哪一行变了。
- 你要在 agent 里一次调用直接拿到结构化 JSON,不想自己解析 DOM。
- 你要抓的是 JS 渲染页、登录墙后的内容,或者要点一下、滚一下才出现的内容。
如果你只抓一两个静态文档页,自己 curl 加个解析就够,不必上这个。
段 4 · 局限
- 按页计费,抓深站见底很快。一个 500 页的站点爬一遍就是 500 credits;再叠加 JSON 格式每页加 4,成本翻几倍。
- 并发是速度瓶颈。免费档只有 2 个并发浏览器,Hobby 5 个。爬大站时卡在并发上,不是卡在额度上。
- 限速分端点。免费档对 scrape、map、search 是 10 请求/分钟,对 crawl 和 agent 是 2 请求/分钟。批量抓要退避,否则吃 429。
- 计费口径有分歧。官方定价页表格里监控写 1 credit/页/次,正文又提到确定性抽取引擎 7 credits/页/次。上量前用自己的账号跑几十页对一下账单。
- 本文未在你的账号实测,抓取成功率和反爬表现没有跑过,自建路线也没测。
段 5 · 今天怎么开始
- 直接调 scrape 接口。请求体里 formats 先只传 markdown,拿到纯文本再说。
- 要字段就加 json 格式并附上 JSON schema。记住这一步把单页成本从 1 credit 提到 5 credits。
- 抓整站用 crawl 接口,它异步返回一个 job id,你轮询取结果。批量抓用 batch scrape,与 crawl 共用限速。
- 定时监控只抓指定页面,别整站重爬。每次重爬都按页重新计费。
- 先用免费档的 1,000 credits 跑一个 200 页左右的目标,量一下实际页数和失败率,再决定买哪一档。
段 6 · 来源
- 定价页:https://www.firecrawl.dev/pricing (核验日期 2026-10-06,美元档)
- 官方文档:https://docs.firecrawl.dev
- 页面可查:五档方案、每月额度、并发数、各端点限速、credit 换算规则、失败请求计费规则、额度结转政策
- 页面未提供:抓取成功率与反爬表现的实测数据
一条能跑起来的最小流程
把两个工具串成一条线,输入是一批网址,产出是一份结构化的 JSONL:
- 输入:一份网址清单。建议先从 10 个页面起步,跑通再上量。
- 抓取:Firecrawl 把每个 URL 转成 markdown,或按 schema 转成 JSON。带 JSON 格式的按 5 credits/页估成本。
- 去重截断:按 URL 和正文哈希去掉重复页;超过模型上下文的部分先截断或切片。
- 抽取:把清洗后的文本交给 Groq 的 gpt-oss-20b,按固定字段输出,temperature 设 0.2。
- 上量:如果是几万条,改走 Groq 的批量接口,成本减半,接受最长 7 天的窗口。
- 落盘:输出统一存成 JSONL,一条一行,方便下次做 diff。
- 复核:随机抽 10 条,回原文核对数字和专有名词。
关键在第 3 步。抓来的文本不去重不截断,token 会全花在重复内容上,这一步直接决定成本。
可以直接复制的提示词
你是网页信息抽取器。我会给你一段来自某网页的正文文本,以及一个字段清单。 只输出一个 JSON 对象,不要解释,不要加代码块标记。 字段清单里没有的键不要输出。正文里找不到的字段,值填 null,不要编造。 所有数字、日期、专有名词必须与正文完全一致,不得改写或换算。 如果正文明显缺失关键信息,返回 {"error": "insufficient_content"}。
怎么判断这次输出合格:抽三条样本,逐字段回原文核对。数字和专有名词全部一致、空值确实在原文里找不到、没有多余键,这三条都满足才算过。
边界声明
- 两个主角都未在你的账号中部署。Groq 未做延迟与吞吐实测,Firecrawl 未测抓取成功率与反爬表现。
- 价格核验日期均为 2026-10-06。Groq 取自官方文档,美元标价;Firecrawl 取自官方定价页美元档,该页面会按访问地切换币种。
- 全文唯一一处成本数字($2.25 与 $1.125)按官方标价与固定 token 数算出,未实测。
- 待确认两项:Groq 限速页免费档与开发者档的归属,页面标签与页内说明文字有出入;Firecrawl 监控功能的计费口径,表格写 1 credit,正文写 7 credits。