每日 AI 简报 · 2026-10-11
今天只讲一件事:把「生成」和「判断」分到两个账本上。生成那一步按单元计价,判断那一步按神经元计价,各花各的钱。
fal.ai:把图、视频、音频、3D 生成收进一个队列 API
段 1 · 是什么
它把几十家模型的生成接口收成一套 REST 调用。你省掉的是自己租 GPU、自己搭队列、自己给每个模型单独写轮询这一步。所有模型走同一个地址 queue.fal.run,返回同一个结构。
段 2 · 多少钱
以下均为官方价格页口径,美元,美国区,核验日期 2026-10-11。
自部署 GPU 列表价:H100 80GB 每小时 4.50 美元,批量低至 2.49;H200 6.00,低至 2.99;RTX PRO 6000 4.00,低至 1.99;B200 7.99;GB200 9.99;B300 12.99。
模型 API 按单元计价:
- 图:Nano Banana 2 每张 0.08;Nano Banana Pro 每张 0.15;上一代 Nano Banana 每张 0.0398;Flux 3 编辑每百万像素 0.024;Z Image Turbo 每百万像素 0.005。
- 视频:MiniMax H3 Max 三个端点均每秒 0.05;H3 Max Turbo 每秒 0.025;Kling v2.5 Turbo Pro 每秒 0.07;Kling v3 Pro 每秒 0.14;Seedance 2 每千 token 0.014。
- 音频:ElevenLabs 多语言 v2 每千字符 0.1;ElevenLabs Turbo v2.5 每千字符 0.05;xAI TTS 每千字符 0.015;ACE Step 每秒 0.0002。
- 3D:Tripo H3.1 每 credit 0.01;Trellis 每次 0.02;Meshy 6 预览每次 0.8。
三个要留意的坑。
第一,官方在表下写明单价按「列表单位」计,每 1 美元能买多少单位只是近似值。
第二,视频按秒计价,改分辨率等于改单价,不要拿每秒 0.05 直接乘总时长。
第三,表里 GPT Image 2 那行标的是每单元 1 美元,换算口径没写清,按待确认处理。
价格页没有免费额度说明,本期也没有在账号里充值实测。
段 3 · 适合谁
你在同一条提示词上要横评三家出图模型,不想为每家单独开户、单独写轮询。你要把生成塞进夜间批量任务,早上直接收结果。你需要按秒试拍视频,而不是先买断一个月的订阅。这三类场景的共同点是调用量不稳定,按单元计价比包月更接近真实用量。
段 4 · 局限
额度与计费:计费单位是单元,分辨率、时长、步数都在乘这个单元,最容易失控的就是这里。
接口依赖:请求要带 Authorization: Key。本地图片不能当路径直接传,要先上传换成 URL,小文件可用 data URI,大文件必须先上传。
对账口径:提交后返回两个 ID,request_id 和 gateway_request_id。发生重试时两者会不一致,对账只认后一个。
输出可靠性:生成模型本身不确定,换分辨率、换步数都会让同一 seed 出不同的图,成片必须人工过一遍。
段 5 · 上手路径
- 先算账再放量。200 张 Nano Banana 2 就是 200 乘 0.08,10 条 5 秒 Kling v3 Pro 就是 50 秒乘 0.14。先跑 3 条样本,用真实账单校准单价,再决定批量规模。
- 走队列,不要挂长连接。用
POST https://queue.fal.run/{model_id}提交拿request_id,再GET .../requests/{request_id}/status轮询状态。视频这类长任务直接在提交地址后加?fal_webhook=,让 fal 回调你的端点。 - 控制重试。加
x-fal-no-retry请求头可以关掉平台自动重试,避免同一张图重复计费。 - 素材落盘。输入图片先上传换成 fal 的 URL 再喂给模型;输出图挂在 fal.media 域名下,收到回调要立刻转存到你自己的存储。
段 6 · 来源
价格页 https://fal.ai/pricing ,队列与 webhook 文档 https://fal.ai/docs/model-endpoints/webhooks ,核验日期 2026-10-11。
边界声明:本期未在你的账号中部署 fal,未做性能与失败率实测。
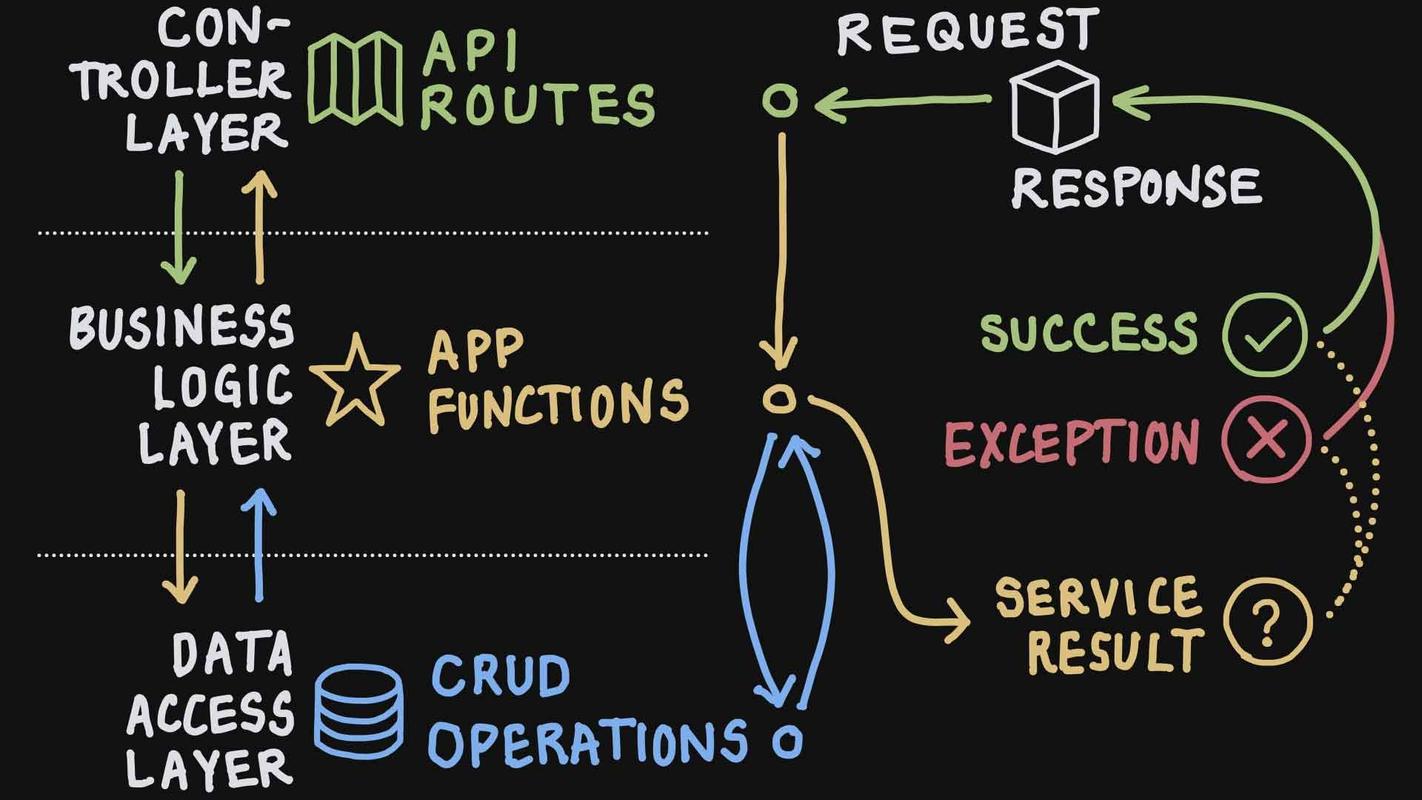
Cloudflare Workers AI:把打标、嵌入、分类压到每千神经元 0.011 美元
段 1 · 是什么
它让你把一次小模型推理直接跑在边缘节点上,按神经元计费。你省掉的是为一次分类请求维护一个常驻服务。图片打标、文本嵌入、语音转写这类小活最合适。
段 2 · 多少钱
官方文档口径,美元,核验日期 2026-10-11。
统一价:每 1000 神经元 0.011 美元,每天 10,000 神经元免费,按 UTC 零点重置。
超免费额度有两条路:升级 Workers Paid,该计划每账号每月最低 5 美元;或充 AI Gateway 的预付费额度。
官方同时给出等价的 token 价,下面这组可以直接拿来换算。
- llama-3.1-8b-instruct-fp8-fast:输入每百万 token 0.045,输出 0.384。
- llama-3.2-3b-instruct:输入每百万 token 0.051,输出 0.335。
- gpt-oss-120b:输入 0.35,输出 0.75。
- bge-m3 嵌入:输入每百万 token 0.012。
- whisper:每分钟音频 0.0005。
- flux-1-schnell 出图:每个 512x512 贴片 0.0000528,每步再加 0.0001056。
免费额度能顶多少活,可以自己算。按 llama-3.2-3b 的 4625 神经元每百万输入 token 折算,10,000 神经元约等于每天 216 万输入 token,折美元约 0.11。
两个坑。部分模型如 kimi-k2.6、kimi-k2.7-code、glm-5.2、glm-5.3、deepseek-v4-flash 必须先绑定付费方式才能调用。另外免费额度是账号级按天算,不按 key 分,用 wrangler 本地模式跑的推理同样计入。
段 3 · 适合谁
你有一批图片要打标签、一批文章要算嵌入建索引、一批音频要转写,且希望成本可预测。你想在请求进来时就地算完返回,不想再起一个服务。你已经把素材生成放在别处,只想把判断这一步压到最便宜的通道。
段 4 · 局限
限速是硬上限,按任务类型分:文本生成每分钟 300 次请求;文生图 720 次;文本嵌入 3000 次,其中 bge-large 是 1500 次;语音识别与图生文 720 次;图像分类和物体检测 3000 次。超限直接报错。
需要付费方案的模型另有独立限速:按标准计费每分钟 20 次,改用 AI Gateway 预付费额度才提到 50 次。
模型目录以开源中小模型为主,前沿模型有限,选型空间比按 token 计价的大厂窄。
计费单位是神经元,单次请求花了多少神经元在模型页上看不出来,只能去控制台看用量。
段 5 · 上手路径
- 先把神经元价换成你熟悉的单位:单价除以 1000 再乘 0.011,得到每百万 token 的成本,再乘你的平均请求量,判断免费额度够不够。
- 用 Workers 的 AI binding 或 REST 接口调用,注意 wrangler 本地推理同样计入额度与限速。
- 额度不够时二选一。升级 Workers Paid,付费模型限速仍按每分钟 20 次;或充 AI Gateway 预付费额度,并把网关的 Workers AI 计费设为 Unified billing,换到每分钟 50 次。
- 批处理别写顺序 for 循环。300 次每分钟这道线一旦撞上就是直接丢请求,脚本要带退避重试和失败队列。
段 6 · 来源
价格页 https://developers.cloudflare.com/workers-ai/platform/pricing/ ,限速页 https://developers.cloudflare.com/workers-ai/platform/limits/ ,核验日期 2026-10-11。
边界声明:本期未在你的账号中开通 Workers Paid,未做并发压测。
实战流程:生成、打标、入库、对账
一条最小可用链路的编号步骤,每步都写清输入和输出。
- 建清单。把要出的图或视频写成 CSV,列含 prompt、model_id、单位、分辨率或时长。输出:待执行清单。
- 估成本。脚本按官方单价表逐行算预估费用,先只放 3 条。输出:单条真实单价。
- 提交队列。用
POST https://queue.fal.run/{model_id}提交,附上?fal_webhook=。输出:request_id与gateway_request_id。 - 收结果并落盘。回调进来后立刻下载到本地存储,同时记下两个 ID、模型名、耗时、实际计费单元。输出:素材与台账行。
- 打标。把素材交给 Workers AI 的小模型做分类或嵌入,注意免费额度与按任务类型的限速。输出:标签或向量。
- 对账。把台账里的预估费用和真实账单对齐,用
gateway_request_id去重,避免重试被重复计数。输出:误差表。 - 归档。把台账和素材索引写成一份 JSON,下次出图先查台账,避免重复花钱。输出:可复用的成本底账。
可复制的提示词
你是素材成本核算助手。给你一个 CSV,列为 prompt、model_id、unit、size、duration,再给你一份单价表,格式是 model_id 对应单价。请输出一张表,列含原始 prompt、规范化后的 prompt、model_id、单位、数量、单条成本、总成本、待人工确认项。规则三条。第一,单价表里没有的模型一律填「待确认」,不许估算。第二,分辨率和时长会翻倍计价的,给出上限与下限两列。第三,拿不准的字段留空,不要编造。
验证标准:抽 3 条用官方单价手算,与输出比对,金额必须完全一致。单价表缺项时「待确认」列必须非空。金额列不允许出现单价表里没写过的数字。